Tre strumenti di sicurezza, tre report, una sola decisione
SAST, DAST e SCA vedono ognuno uno strato. Un agente in GitLab CI li legge insieme a ogni build e dice cosa blocca il rilascio, e perché.
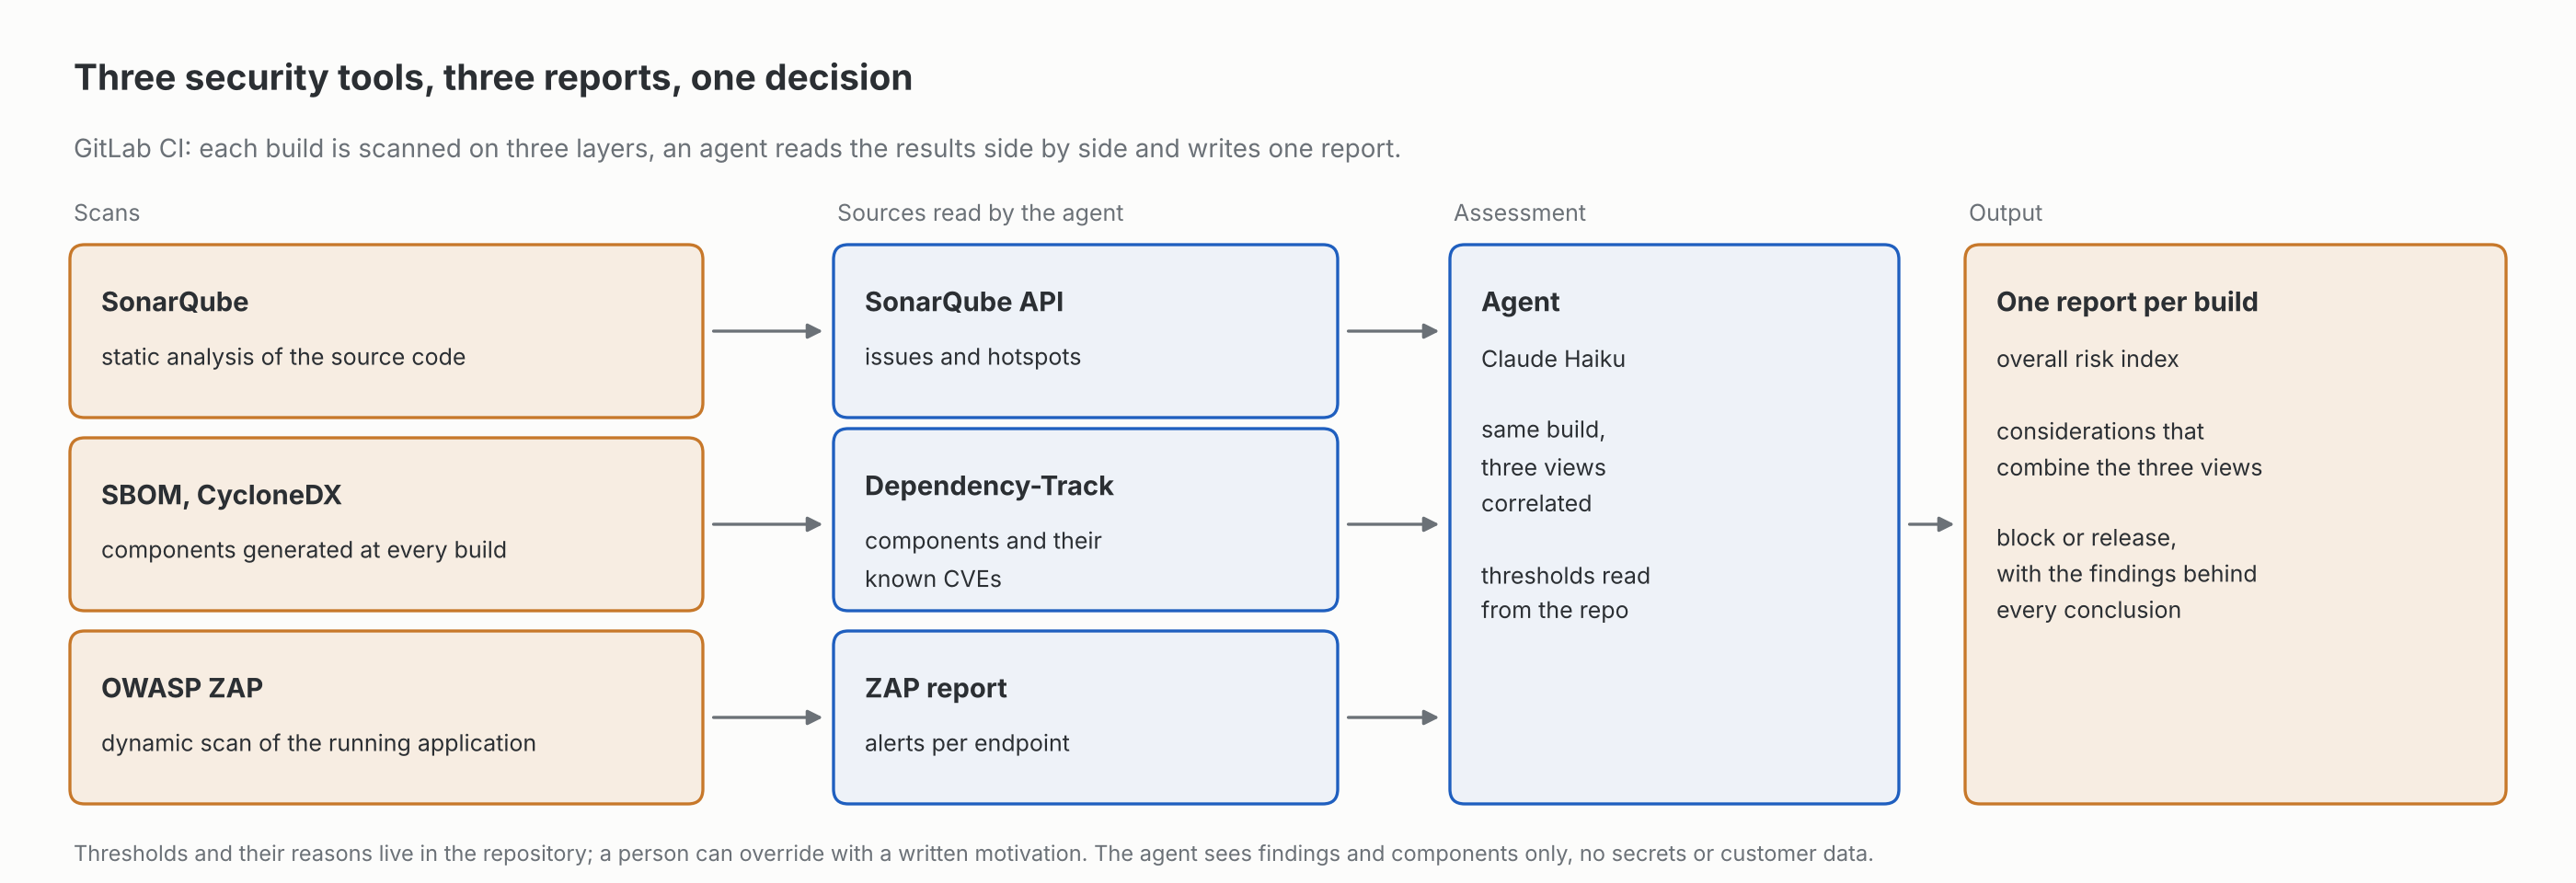
Nelle pipeline che prendono sul serio la sicurezza applicativa girano almeno tre controlli. SonarQube legge il codice sorgente (SAST). OWASP ZAP attacca l’applicazione dall’esterno, mentre gira (DAST). La SBOM, generata a ogni build in formato CycloneDX e caricata in Dependency-Track, elenca ogni componente con le vulnerabilità note (SCA). Ognuno vede bene il suo strato. Nessuno sa cosa hanno trovato gli altri due.
Il risultato lo conosce chi ha mantenuto una pipeline del genere: tre cruscotti, tre scale di gravità, una lista lunga che nessuno legge fino in fondo, e la decisione di rilascio presa sul report che qualcuno ha aperto per primo. Una vulnerabilità critica in una libreria pesa uguale sia che la funzione vulnerabile sia raggiungibile da internet, sia che non venga mai chiamata. Un avviso di ZAP su un header e un hotspot di SonarQube sullo stesso endpoint vengono valutati separatamente, da persone diverse, in giorni diversi.
Un agente dopo le tre scansioni
Quando ero CTO di una software house B2B ho aggiunto alla pipeline GitLab uno stadio con un agente dopo le tre scansioni. Legge i finding di SonarQube, il report di ZAP e i componenti con le vulnerabilità tenuti in Dependency-Track per la stessa build, e scrive un report unico: un indice di rischio complessivo, poi le considerazioni che sommano i tre punti di vista. Quali finding sono la stessa debolezza vista da lati diversi, quali sono esposti nell’applicazione che gira, quali possono aspettare, se il rilascio va bloccato. Ogni conclusione porta con sé i finding su cui si basa, così una persona la verifica in fretta invece di ricostruirla.
Il modello è Claude Haiku, piccolo e veloce, per scelta. La parte difficile non è la potenza di ragionamento: è mettere davanti al modello i finding giusti, affiancati, e limitare ciò che può concludere. Un modello più grande che legge dati preparati male non farebbe meglio.
Tre regole che contano più del modello
L’agente non decide da solo cosa blocca un rilascio. Le soglie di blocco sono scritte nel repository con il motivo accanto a ognuna; l’agente le applica e spiega la sua lettura, e una persona può scavalcarle con una motivazione scritta.
L’agente non vede più di quanto gli serve. Finding, elenchi di componenti ed endpoint, mai segreti, credenziali o dati dei clienti.
La pipeline deve dimostrare di saper fallire. Prima di fidarsi della valutazione si introducono apposta un componente vulnerabile noto e un endpoint debole noto, e la build deve diventare rossa. Un controllo di sicurezza che non si è mai visto fallire non è un controllo.
Limiti
L’agente riduce il lavoro di lettura, non la responsabilità: un falso negativo di uno dei tre strumenti resta un falso negativo anche dopo l’agente. La raggiungibilità è valutata da quello che gli strumenti riportano, non dimostrata con un exploit. Niente numeri su tempi di analisi o falsi positivi: i dati delle build sono rimasti all’azienda dove lo stadio è stato costruito, e non cito cifre che non posso mostrare.