Dfence: circa 100 appliance di sicurezza governate con SaltStack
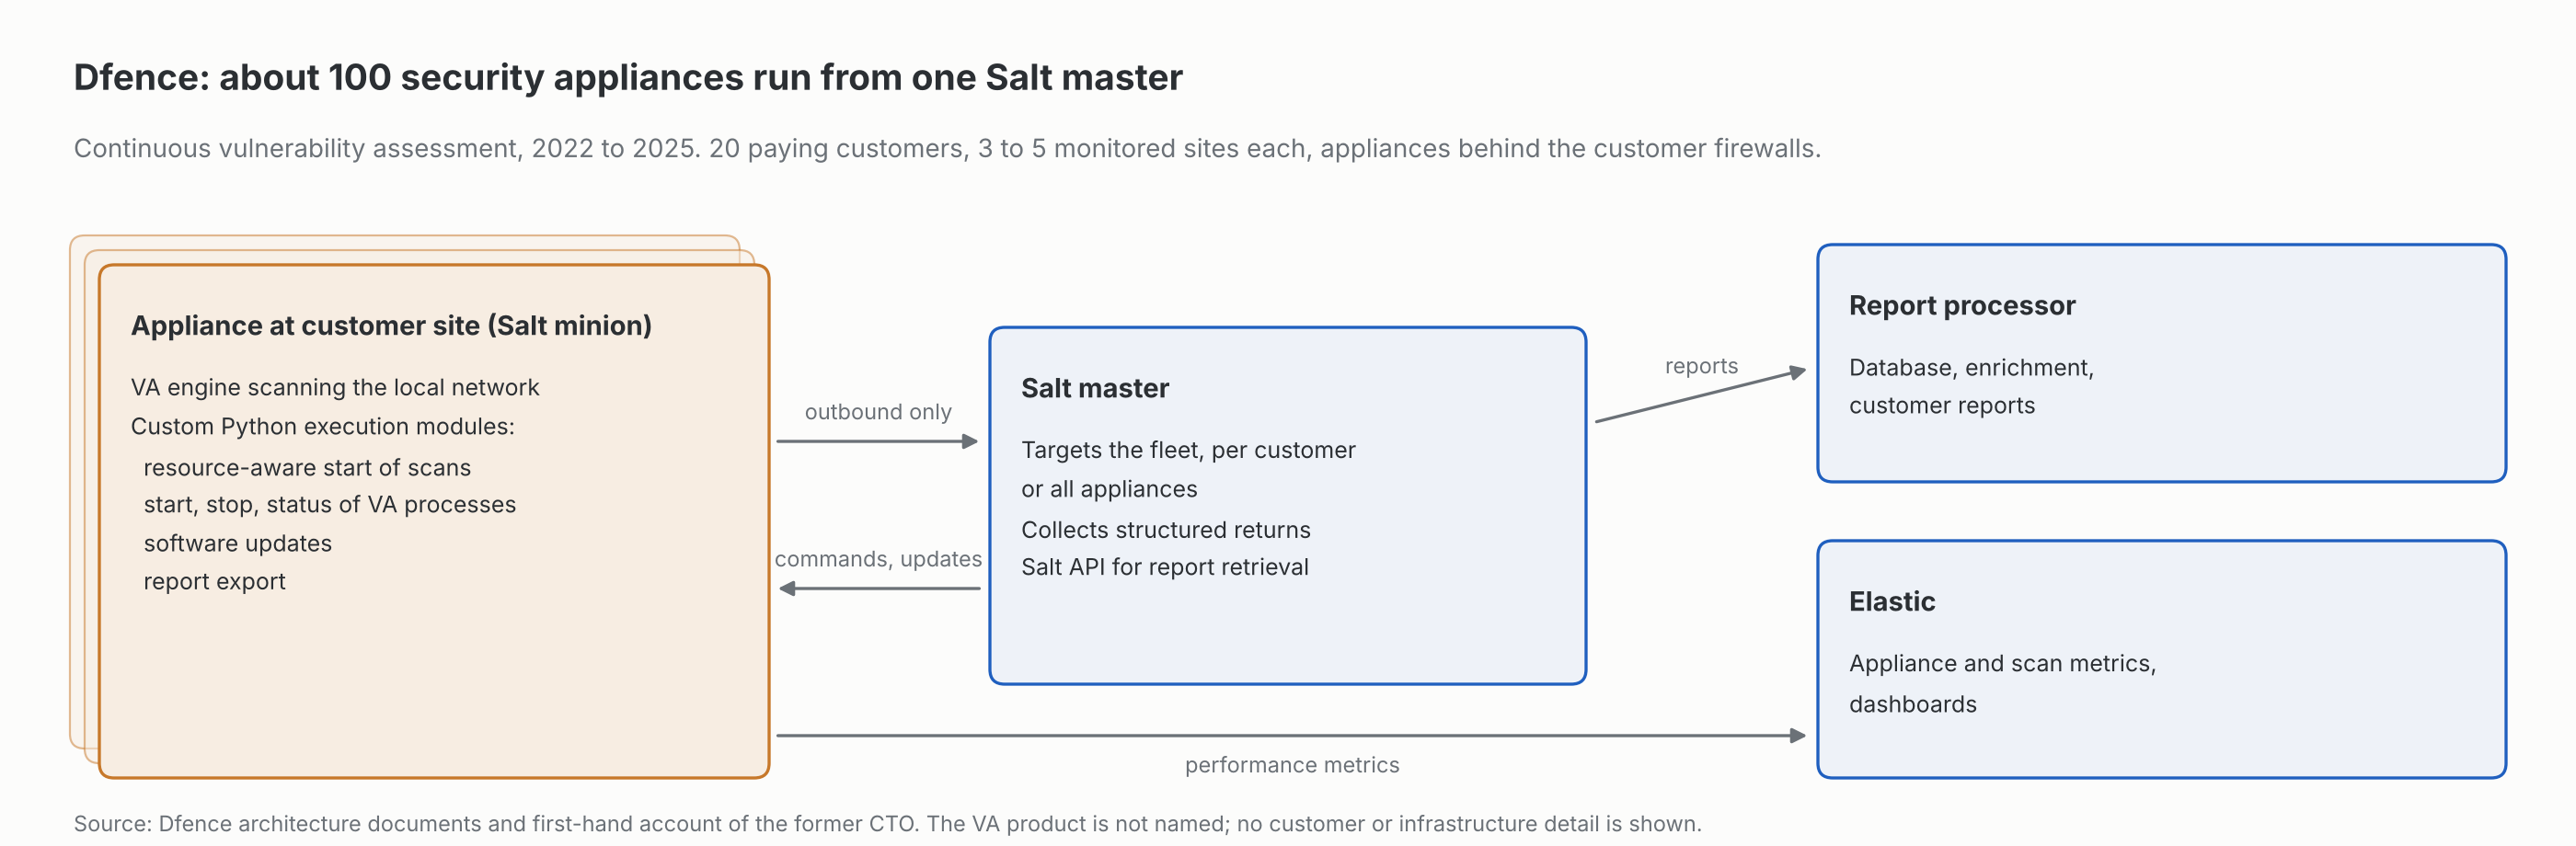
Dfence era un servizio di vulnerability assessment continuo per reti aziendali, che ho co-fondato e guidato come CTO e Head of Product dal 2022 al 2025. Il servizio è arrivato a 20 clienti paganti, ciascuno con 3-5 sedi monitorate. Appliance di sicurezza fisiche installate presso i clienti eseguivano il motore di vulnerability assessment sulla rete locale; al massimo la flotta contava circa 100 appliance, tutte dietro i firewall dei clienti e nessuna raggiungibile dall’esterno.
Il problema operativo è quello di ogni azienda che vive di appliance. Cento macchine in cento reti diverse vanno avviate, fermate, aggiornate e lette, e ognuna può scansionare solo quanto il suo hardware permette. Entrare su ognuna a mano non scala, e uno script generico di esecuzione remota non sa cosa sta facendo il motore di scansione.
Ho scelto SaltStack (Salt) come piano di controllo. Ogni appliance era un minion Salt collegato in uscita a un master centrale, cosa che si adattava ai firewall dei clienti: nessuna porta in ingresso dal lato cliente. Sopra Salt ho scritto moduli di esecuzione in Python che parlavano con il motore di scansione attraverso la sua API di gestione, così ogni operazione sulla flotta era una chiamata Salt con un risultato strutturato e leggibile da una macchina, invece di un comando di shell con del testo da interpretare.
Cosa facevano i moduli
Avvio delle scansioni in base alle risorse. Una scansione pesa su CPU, memoria e rete, e avviare tutti i task programmati insieme su un’appliance piccola li degrada tutti. Il modulo controllava cosa la macchina poteva reggere e lanciava i processi di conseguenza, tenendo il numero di scansioni contemporanee dentro la capacità dell’appliance.
Avvio, arresto e stato dei processi di scansione, su tutta la flotta o per singolo cliente, dal master, con il risultato di ogni minion restituito al master.
Aggiornamenti del software di scansione su tutta la flotta. Feed e immagini del motore cambiavano spesso e bloccare le versioni non era praticabile, quindi gli aggiornamenti partivano dal master per gruppi controllati invece di essere lasciati a ogni macchina.
Raccolta dei report. I report completati venivano recuperati attraverso la Salt API e inoltrati a un elaboratore centrale, che li caricava in un database, li arricchiva e produceva quello che il cliente riceveva.
Monitoraggio delle prestazioni. Le metriche di appliance e scansioni andavano in Elastic, così un’appliance lenta o sovraccarica compariva su un cruscotto prima di diventare un reclamo.
Perché conta
È la stessa disciplina che applico oggi alle piattaforme web: un solo piano di controllo, operazioni che restituiscono dati invece di testo, capacità trattata come un vincolo da rispettare invece che da scoprire in produzione, monitoraggio che mostra il problema prima del cliente.
Limiti
La dimensione della flotta è una mia dichiarazione da ex CTO. Nessun dato su tempi di rilascio, throughput delle scansioni o latenza dei report è citato perché non ho misure documentate a sostegno. Il motore di scansione non è nominato e nessun dettaglio su clienti, reti o infrastruttura è pubblicato.